老V100跑图片embedding的那些事
去年我写过一篇用ktransformers跑671b的DeepSeek R1,里面那台”4块V100的GPU卡”的机器,最后只跑出了 1 token/s 左右,基本只能拿来研究研究。没想到一年多过去,它又被我翻出来干活了:这次是给一大批图片做 embedding,用来做以图搜图。用的模型是 Qwen3-VL-Embedding-8B,全量跑一遍要十几天。
活儿本身倒是跑起来了,但过程中我被问(也自己问自己)了好几个问题:V100 为啥用不了 BF16?FA2 到底是个啥?每张图 256 个 visual tokens 到底算多还是算少,会不会影响搜索效果?换个 token 数速度又差多少?查资料加实测折腾了一圈,算是把这几个概念理顺了,整理成一篇学习笔记,分享给有需要的朋友。
先说结论:V100 能用的只有 FP16
这台机器的配置跟那篇里一样:4 块 V100,每块 16G 显存,计算能力(compute capability)是 7.0,也就是 Volta 架构。这个 7.0 是关键,后面一堆”用不了”都是因为它。
8B 的模型,FP16 权重差不多就把一张 16G 的卡塞满了(实测只剩一百来 MB 余量),所以最后的部署方式是每张卡跑一个副本、batch 1,四张卡加起来大概 30 张图/秒。至于为什么不把一个模型切到多张卡上、为什么不开更大的 batch,那又是另一个故事了。。。
FP16、BF16、FP8 有什么区别?
浮点数由三部分组成:符号位、指数位、尾数位。指数位决定能表示的范围,尾数位决定精度。理解了这一句,这几种格式的区别就很好懂了:
|
1 2 3 4 5 6 |
格式 位宽 指数/尾数 最大值 大约有效位数 最早支持的硬件 FP32 32 8 / 23 ~3.4e38 ~7 位 所有 GPU FP16 16 5 / 10 65504 ~3 位 Volta(V100)起有 Tensor Core BF16 16 8 / 7 ~3.4e38 ~2 位 Ampere(A100)起 FP8 E4M3 8 4 / 3 448 ~1 位 Hopper(H100)/ Ada 起 FP8 E5M2 8 5 / 2 57344 更低 同上 |
FP16
FP16 的优点是:在 16 位格式里精度最高,而且 V100 就已经有 Tensor Core 支持,算力是 FP32 的好几倍,显存和带宽占用也减半。
缺点是范围太小,超过 65504 就溢出成 inf,然后就是一路 NaN。大模型的激活值里经常有少量特别大的离群值,尤其是那些用 BF16 训练出来的模型,训练的时候根本不用操心溢出,拿到 FP16 下推理就可能在某一层炸掉。Qwen3-VL 官方就是按 BF16 发布的,在 V100 上只能用 FP16 硬跑(好在我们这边输出一直是正常的)。
BF16
BF16 的思路很直接:拿精度换范围。它的指数位和 FP32 一样是 8 位,所以范围也和 FP32 一样大,基本不会溢出,训练时也不需要 loss scaling,从 FP32 转过来几乎没坑。代价是尾数只剩 7 位,精度比 FP16 差。
对深度学习来说,范围比精度重要得多,所以 BF16 成了现在大模型训练的事实标准。可惜要 A100(计算能力 8.0)及以上才支持,V100 就只能看着了。。。
FP8
FP8 是再砍一半:Tensor Core 算力大约是 BF16 的 2 倍,权重显存也减半,对推理吞吐很有吸引力。但它的精度和范围都非常有限,必须配合缩放因子(per-tensor、per-channel 或 per-block 的 scale)才能用,还要校准,可能带来能感知到的精度损失。
它有两个变体:E4M3 精度稍高,一般用于前向的权重和激活;E5M2 范围更大,一般用于反向的梯度。需要 H100、L40 这一代的卡。PS:即使是 E4M3,能表示的最小正数,也只是 0.00195 而已,是个什么精度,可以以此为参考。
对 embedding 这种要比较向量相似度的任务,我会比较谨慎:真要上 FP8,得先拿一批固定的图,对比 FP8 和 BF16 算出来的向量 cosine 相似度,再看 top-k 召回的重合率,不能光看速度。
FA2 又是什么?
FA2(FlashAttention-2)不是数值格式,而是 attention 的一种计算实现(kernel)。它之所以总跟 BF16、FP8 被放在一起说,是因为它们都卡硬件,而 V100 正好都用不上(哈哈,难兄难弟)。
标准的 attention 要先算出一个 N×N 的分数矩阵(N 是序列长度),写回显存,再读回来做 softmax,再乘 V。这个过程的瓶颈其实不在计算,而在显存读写,而且显存占用是 O(N²),序列一长就爆。
FlashAttention 的做法是把 Q、K、V 切成小块,放进 GPU 片上的 SRAM 里,把”matmul → softmax → matmul”融合进一个 kernel 里算完。softmax 用”online softmax”的技巧逐块更新,完全不需要生成完整的 N×N 矩阵。所以:
1. 结果是精确的,不是近似 attention。
2. 显存从 O(N²) 降到 O(N)。
3. 一般比标准实现快 2~4 倍,序列越长越明显。
但它要求 Ampere 及以上(计算能力 8.0+),只支持 FP16/BF16 输入。去年那篇里我还专门折腾过 flash-attn 的安装,现在回头看,V100 本来就不是它的目标硬件。。。在 V100 上能用的替代是 PyTorch 的 SDPA,它有一个 memory-efficient 后端,能省一些显存,但速度比不上 FA2。
另外要说一句:我们每张图只有 256 个 visual tokens,序列很短,attention 本来就不是主要开销。所以就算换了新卡,提升主要来自更强的 Tensor Core 和更大的显存(终于能开真正的 batch 了),FA2 只是锦上添花。
256 个 visual tokens 是什么水平?
先搞清楚一个 token 对应多少像素。Qwen3-VL 的视觉编码器把图切成 16×16 的 patch,再把 2×2 个 patch 合并成 1 个 token,所以 1 个 token = 32×32 像素。注意这跟 Qwen2-VL 的 28×28 不一样,网上很多资料还是按老的算法讲的。
这样算下来,256 tokens 大约是 26 万像素,正方形图就相当于 512×512。非正方形的图会保持长宽比,总像素不变。跟常见的检索模型比一下:
|
1 2 3 4 5 |
方案 等效输入分辨率 CLIP ViT-L/14 @224 224×224(256 个 patch) SigLIP @384 384×384(729 个 patch) Qwen3-VL @256 tokens 约 512×512 Qwen3-VL 默认上限 1280 tokens 约 1145×1145 |
所以 256 在 Qwen3-VL 自己的可选范围里算偏低档,差不多只有默认上限的 1/5;但跟业界常用的检索模型比,分辨率一点也不低,像素量差不多是 CLIP 224 的 5 倍。
它会影响以图搜图吗?
先理解一点:不管输入多少 token,最后都会被压成一个 4096 维的向量。这个向量主要编码的是图片的整体语义:是什么东西、什么风格、什么颜色、什么构图。token 数决定的是模型”看得多清楚”,而一个向量本身能装下的细节也是有上限的。
基本不受影响的场景:
1. 同一张图,或者压缩、缩放、轻微裁剪、加水印后的近似重复图。实测拿库里已有的图去搜,自己匹配自己的得分是 1.0001,非常稳。
2. 同款商品换了角度、背景或模特,找同类、找风格相似的图。这些靠的是整体外观,512 像素已经足够看清。
可能明显受影响的场景:
1. 图里的文字:品牌名、型号、价格标签、包装上的小字。512 像素下小字大概率已经糊了,Qwen3-VL 本来不错的 OCR 能力在这里就浪费了。
2. 细粒度区分:同一系列的不同型号、纹理图案上的细微差别、很小的 logo。
3. 小目标:要找的东西只占原图很小一块。
4. 极端长宽比:长截图、长图、横幅。总像素是固定的,长边一拉长,短边就被压得很小。
要说明的是,上面这些是根据原理做的判断,不同 token 数下的召回率我还没有实测过(GPU 正忙着跑全量,抽不出来😂)。打算等全量跑完,抽一部分图片分别用 256、512、1280 建几个小索引,按场景分组比一下 recall@10,用数据说话。
换个 token 数,速度差多少?
这个倒是实测过的。同一批图,8B 模型,batch 8,计时前已经做完 resize,只算 GPU 部分:
|
1 2 3 4 5 6 |
visual tokens 等效分辨率 每张耗时 相对 256 64 ~256² 48.7 ms 0.40× 128 ~362² 67.2 ms 0.55× 256 ~512² 121.3 ms 1× 512 ~724² 223.3 ms 1.84× 1024 ~1024² 538.9 ms 4.44× |
可以看到,token 数每翻一倍,耗时大约变成原来的 2.0~2.6 倍,比线性增长还快。原因也好理解:MLP 部分的开销跟 token 数成正比,attention 部分则是 O(n²)。
换算到全量任务上:现在 256 tokens 要跑十几天,换成 512 就得一个多月,换成 1024 得两个多月,而且 1024 在单张 16G 的 V100 上大概率直接 OOM(权重已经快把显存占满了,激活值一大就放不下)。这也是当初选 256 的原因。
另外有两个一开始让我有点意外的结论:
1. 原图分辨率几乎不影响 GPU 速度。 256 tokens 预算下,原图是 512²、1024²、2048²、4096² 时,GPU 耗时分别是 102.3、102.9、102.6、102.8 ms,几乎是一条直线,因为图片会先被缩到 token 预算以内。原图越大,只会多花一点 CPU 解码 JPEG 的时间(大约每百万像素 8.4 ms),远远赶不上 GPU 的速度,不会成为瓶颈。所以速度只看 token 预算。
2. 长宽比也几乎不影响速度。 图片是等比缩放的,不加 padding 也不裁剪,耗时只跟最终的 token 数有关,3:1 和 1:3 只差 3%。
几个坑
1. 查询和建库必须用同一个 token 数。 这是最隐蔽的一个坑:库是用 256 建的,而服务端默认是 512。我拿库里已有的一张图去搜,用 512 算出来的向量跟库里自己的相似度只有 0.938,换成 256 才是 1.0001。它不报任何错,只是悄悄返回更差的结果。这也说明 token 数一改,向量就变了,以后想升级只能全量重算,新旧向量绝对不能混用。
2. 测速时别把 resize 算进去。 直接计时 encode() 的话,里面包含了 processor 的 resize,而 resize 的耗时随原图像素增长,会让原本不变的 GPU 耗时看起来从 512² 到 4096² 翻了三倍。我差点就得出”原图越大越慢”的错误结论。
3. 直接调 processor.image_processor(images=...) 会绕过 token 预算。 预算是作为 min_pixels/max_pixels 在 embedder 的处理流程里生效的,单独调 image_processor 得到的 token 数跟实际流水线对不上,拿来做估算是没有意义的。
4. 长宽比超过 200 会直接报 ValueError。 不会优雅降级。如果图片来源不可控(比如用户上传),得在上游先校验一下。
最后
折腾了一圈,结论其实挺朴素的:V100 只能用 FP16,没有 BF16、FA2、FP8;256 tokens 做以图搜图基本够用,但小字和细节是短板;想要更高的 token 数,代价几乎是翻倍往上涨的。
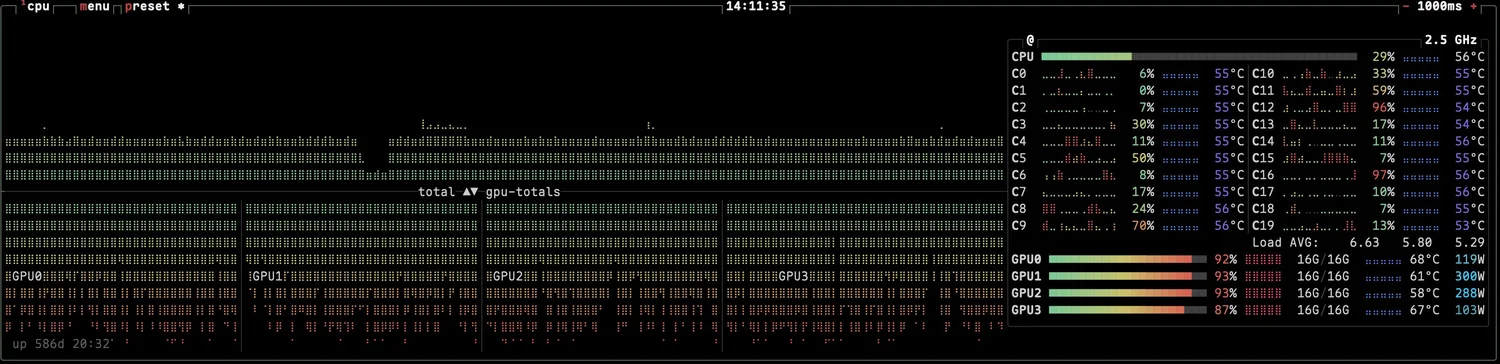
这台老伙计去年跑 DeepSeek 只有 1 token/s,今年总算干上了一份正经工作,接下来还要连轴转二十来天。vibe了一阵之后,利用率已经压榨地比较狠了,如图:
看看能不能顺利跑完吧~
发表回复